Multinook

เครื่องมือแยกและดึงข้อมูล PDF

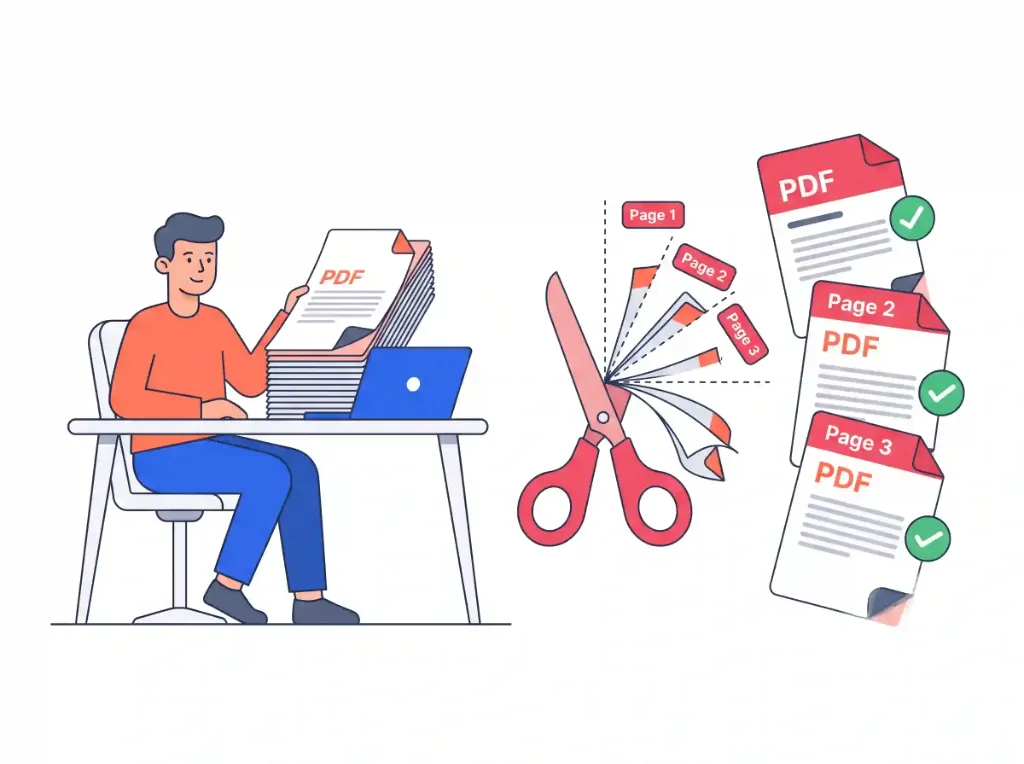
ดึงข้อมูลเฉพาะหน้าหรือแยก PDF เป็นเอกสารอิสระ

Initializing In-Browser RAM Sandbox...
เครื่องมือแยกและดึงข้อมูล PDF — สถาปัตยกรรมทางเทคนิคและข้อมูลจำเพาะ
เอ็นจิ้นประสิทธิภาพสูง

เครื่องมือแยกและดึงข้อมูล PDF

เลือกช่วงหน้า ดูตัวอย่างแผ่นงานแต่ละแผ่น และดาวน์โหลดไฟล์ PDF แยกต่างหากได้ทันทีโดยไม่มีอาการแลคจากเซิร์ฟเวอร์

ตัวเลือกภาพย่อหน้ากระดาษแบบภาพนิ่ง
ไวยากรณ์ช่วงหน้าที่กำหนดเอง
ส่งออกหลายไฟล์ได้ทันที
ไม่ต้องรอ
ความเป็นส่วนตัวของข้อมูลแบบแยกส่วน

การรักษาความลับแบบไม่ต้องอัปโหลด 100%

ไฟล์ของคุณได้รับการประมวลผลภายใน RAM ของอุปกรณ์โดยใช้ WebAssembly อย่างเคร่งครัด ไม่มีการอัปโหลดขึ้นคลาวด์

ประมวลผลผ่าน RAM บนเบราว์เซอร์ 100% • ไม่มีการอัปโหลดไปยังเซิร์ฟเวอร์
ความเป็นส่วนตัวของข้อมูลแบบแยกส่วน
คำแนะนำทีละขั้นตอน

วิธีใช้งานออนไลน์: เครื่องมือแยกและดึงข้อมูล PDF

ทำตาม 3 ขั้นตอนง่ายๆ เหล่านี้เพื่อประมวลผลเอกสารของคุณในเบราว์เซอร์โดยตรงโดยไม่ต้องติดตั้งโปรแกรม

1

โหลด PDF หลายหน้า

วางเอกสารของคุณเพื่อดูตัวอย่างภาพย่อของทุกหน้าได้อย่างรวดเร็วด้วยการเรนเดอร์ในระดับเสี้ยววินาที

2

เลือกหน้าหรือช่วงหน้าที่ต้องการ

คลิกการ์ดหน้าแต่ละหน้าหรือระบุรูปแบบช่วงหน้าที่ต้องการ (เช่น 1-5, 8, 11-14) เพื่อดึงหน้าเป้าหมายออกมา

3

ดาวน์โหลดไฟล์ที่แยกแล้ว

ส่งออกหน้าที่เลือกเป็น PDF รวมไฟล์เดียวหรือเป็นไฟล์แยกเดี่ยวในรูปแบบไฟล์ ZIP ที่บีบอัดแล้ว

การทดสอบความเป็นส่วนตัวและประสิทธิภาพ

ทำไม Multinook ถึงดีกว่าเครื่องมือแปลงบนคลาวด์แบบเดิม

ดูว่าสถาปัตยกรรม WebAssembly ฝั่งไคลเอนต์เปรียบเทียบกับบริการอัปโหลดคลาวด์ทั่วไปอย่างไร

การดึงหน้าเอกสาร

Multinook
ตัวตัดช่วงแบบมองเห็นภาพ
iLovePDF / Adobe
จำกัด 2 ไฟล์/วัน

ราคาและการจ่ายเงิน

Multinook
ฟรี 100% ตลอดไป
iLovePDF / Adobe
$19.99/เดือน (Adobe)

การประมวลผลหลายไฟล์พร้อมกัน

Multinook
ชุดไฟล์ ZIP ทันที
iLovePDF / Adobe
คิวบนคลาวด์ที่ช้า

การอัปโหลดไฟล์ขึ้นคลาวด์

Multinook
0 ไบต์ (ใช้ RAM ในเครื่อง)
iLovePDF / Adobe
อัปโหลดไปยังเซิร์ฟเวอร์

ความเสี่ยงด้านความเป็นส่วนตัวของข้อมูล

Multinook
0% (แยกส่วนแบบ Air-Gapped)
iLovePDF / Adobe
จัดเก็บไว้บนคลาวด์
สถาปัตยกรรมทางเทคนิคและข้อมูลจำเพาะ

ข้อมูลจำเพาะและความเข้ากันได้ของรูปแบบไฟล์

พัฒนาขึ้นตามข้อกำหนด W3C WebAssembly และ Typed Array อย่างเคร่งครัด

เทคโนโลยีการตัดแบ่งการตัดสตรีมไบต์ระดับล่าง (ไม่มีการบีบอัดซ้ำ)
เอนจิ้นไวยากรณ์ช่วงหน้าตัวแยกแยะไวยากรณ์แบบไดนามิกแบบเรียลไทม์ (1-5, 8, 11-14)
โหมดการส่งออกPDF รวมเป็นไฟล์เดียว หรือไฟล์ ZIP หลาย PDF
การรับส่งข้อมูลอัปโหลด 0 ไบต์ • แยกการทำงานใน RAM ของเบราว์เซอร์ 100%
การตัดแต่งโครงสร้างหน้าการถอดอ้างอิงออบเจ็กต์ /Pages แบบแยกส่วนและการเก็บขยะหน่วยความจำ
ความเป็นส่วนตัวและการปฏิบัติตามข้อกำหนดแซนด์บ็อกซ์ที่ไม่จัดเก็บข้อมูล รองรับ GDPR, HIPAA และ CCPA
ข้อสงสัยทั่วไป

คำถามที่พบบ่อย

ทุกสิ่งที่คุณจำเป็นต้องรู้เกี่ยวกับความเป็นส่วนตัว, ความปลอดภัย, ขีดจำกัดของไฟล์ และการใช้งาน

คุณสามารถทำได้ 2 วิธีง่ายๆ: คลิกที่การ์ดภาพย่อของแต่ละหน้าโดยตรงเพื่อเปิด/ปิดการเลือก หรือพิมพ์ไวยากรณ์ช่วงหน้าที่ต้องการในแถบอินพุต (เช่น 1-5, 8, 11-14) โปรแกรมแยกข้อมูลของเราจะตรวจสอบช่วงของคุณแบบเรียลไทม์ทันทีและไฮไลต์หน้าที่กำหนดไว้สำหรับการดึงข้อมูล
ได้ เลือกโหมดการแยก "แยก PDF สำหรับแต่ละหน้า" เอนจิ้นจะตัดทุกหน้าออกเป็นไฟล์ PDF เดี่ยวของตัวเอง และรวมเข้าด้วยกันเป็นไฟล์ ZIP ที่จัดระเบียบและบีบอัดแล้วเพื่อให้ดาวน์โหลดได้ด้วยคลิกเดียว
ไม่ เครื่องมือของเราทำการดึงสตรีมระดับไบต์โดยตรง ต่างจากเครื่องมือที่เรนเดอร์หรือบีบอัดหน้าใหม่ เอนจิ้นของเราจะคัดลอกสตรีมเวกเตอร์ ฟอนต์ และรูปภาพพื้นฐานโดยไม่มีการเข้ารหัสซ้ำ ไฟล์ PDF ที่ดึงออกมาจะรักษาความละเอียด ข้อมูลเมตา และความคมชัดดั้งเดิมไว้ครบ 100%
ในแถบตัวเลือก ให้เลือก "รวมหน้าที่เลือกเป็น 1 PDF" หากคุณต้องการดึงหน้าที่ไม่ได้เรียงติดกัน (เช่น หน้า 2, 5 และ 9) ลงในเอกสารเดียวที่เชื่อมโยงกัน เลือก "แยก PDF สำหรับแต่ละหน้า" หากคุณต้องการบันทึกแต่ละหน้าที่เลือกเป็นไฟล์แยกเดี่ยว
ได้ ด้วยการใช้การแบ่งส่วน ArrayBuffer และการคืนพื้นที่หน่วยความจำของตัวอธิบายหน้าที่ไม่ได้เลือกจากหน่วยความจำระเหย เอนจิ้น WebAssembly ฝั่งไคลเอนต์ของเราจึงสามารถแยกเอกสารที่มีหลายร้อยหน้าบนแล็ปท็อปและโทรศัพท์มือถือทั่วไปได้อย่างง่ายดายโดยที่เบราว์เซอร์ไม่ค้าง

การตัดสตรีมระดับไบต์แบบไม่สูญเสียข้อมูลเทียบกับการลดทอนคุณภาพด้วยการเข้ารหัสซ้ำ

ยูทิลิตี้แยก PDF พื้นฐานจำนวนมากจะเรนเดอร์หน้าใหม่ผ่านไดรเวอร์พิมพ์เสมือนหรือบีบอัดกราฟิกที่ฝังอยู่ซ้ำ ส่งผลให้เกิดอาร์ติแฟกต์การบีบอัดภาพที่สังเกตได้ชัดเจน ข้อผิดพลาดในการแทนที่ฟอนต์ และคำอธิบายประกอบไฮเปอร์ลิงก์ที่หายไป

เครื่องมือของเราทำการดึงสตรีมระดับไบต์โดยตรง เอนจิ้น WebAssembly ของเราจะแยกวิเคราะห์การอ้างอิงออบเจ็กต์หน้าของช่วงเป้าหมายของคุณ (เช่น หน้า 1-5, 8, 11-14) และคัดลอกสตรีมเนื้อหาดั้งเดิมทีละบิตลงในตัวครอบเอกสาร PDF ที่คอมไพล์ใหม่ ฟอนต์เวกเตอร์ที่ฝังอยู่ ภาพ DPI ดั้งเดิม และสเปรซสีจะยังคงอยู่ครบถ้วนไม่ถูกแตะต้อง

การดึงข้อมูลที่ปรับขนาดได้สำหรับเอกสารสแกนขนาดใหญ่

เมื่อทำงานกับเอกสารทางกฎหมาย 500 หน้า เอกสารจำนอง หรือแบบแปลนสถาปัตยกรรมที่เก็บถาวร เครื่องมือเว็บแบบดั้งเดิมมักจะขัดข้องหรือหมดเวลาเนื่องจากข้อจำกัดขนาดการอัปโหลดบนคลาวด์

เนื่องจากเครื่องมือของเราประมวลผลไฟล์ภายในหน่วยความจำเบราว์เซอร์ในเครื่องของคุณโดยใช้การแมปหน่วยความจำ ArrayBuffer จึงทำให้สามารถจัดการไฟล์ขนาดใหญ่หลายร้อยหน้าได้อย่างง่ายดาย คุณสามารถแยกบทหน้าเฉพาะลงใน PDF รวมไฟล์เดียว หรือแตกทุกหน้าเป็น PDF อิสระที่รวมอยู่ในไฟล์ ZIP เดียวได้

ยืนยันความปลอดภัยด้วย RAM บนเบราว์เซอร์ 100%
อัปเดตตามมาตรฐานเว็บปี 2026

เครื่องมือที่เกี่ยวข้อง

ดูเครื่องมือในหมวดหมู่ทั้งหมด →