L'ingegneria dietro la compressione PDF in-browser
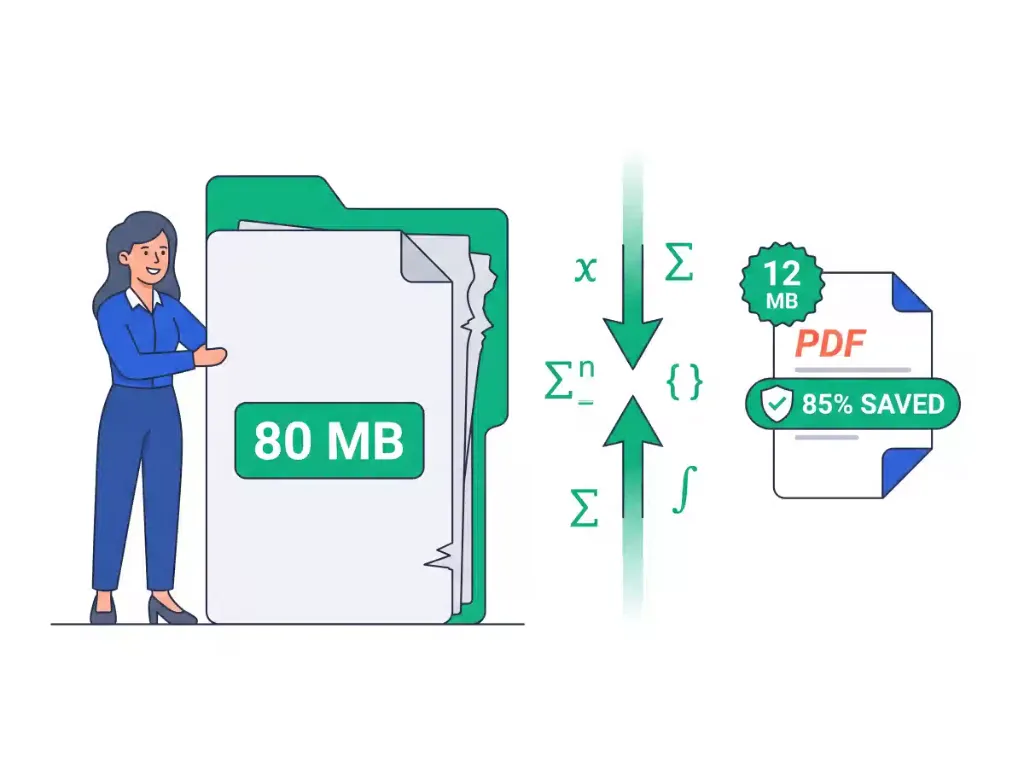
I compressori online tradizionali caricano documenti PDF di diversi megabyte su server farm cloud remote, introducono latenza di coda e spesso si affidano a script server lossy come Ghostscript che trasformano il testo vettoriale in bitmap sfocate e pixelate. Questo flusso di lavoro obsoleto crea gravi rischi per la privacy di rapporti finanziari riservati, contratti e cartelle cliniche.
Il nostro motore di compressione a doppio passaggio opera interamente all'interno del runtime WebAssembly isolato del tuo browser. Nel Passaggio 1, il motore Ispeziona la tabella di riferimento incrociato (xref) del PDF, rimuove le revisioni obsolete non referenziate, rimuove le tabelle di hinting TrueType non essenziali (come hdmx, VDMX, LTSH e PCLT) e deflaziona i flussi di oggetti grezzi (/ObjStm) senza toccare i vettori dei glifi del testo.
Quando è richiesta una riduzione più profonda, il Passaggio 2 valuta le immagini raster incorporate. Sfruttando la quantizzazione DCT (transformata discreta del coseno) di livello MozJPEG, le fotografie incorporate vengono ricampionate a target DPI calibrati (da 96 a 150 DPI) e reinserite nei confini esatti della pagina fisica. Poiché tutti i calcoli vengono eseguiti nella RAM del tuo dispositivo tramite Web Workers, i tuoi documenti rimangono privati al 100% con velocità di esecuzione inferiori al secondo.