Inženýrství stojící za kompresí PDF v prohlížeči
Tradiční online kompresory nahrávají vícemegabajtové dokumenty PDF na vzdálené cloudové servery, způsobují latenci ve frontě a často spoléhají na ztrátové serverové skripty, jako je Ghostscript, které převádějí vektorový text na rozmazané, pixelové bitmapy. Tento starší pracovní postup vytváří vážná rizika pro ochranu soukromí u důvěrných finančních zpráv, smluv a lékařských záznamů.
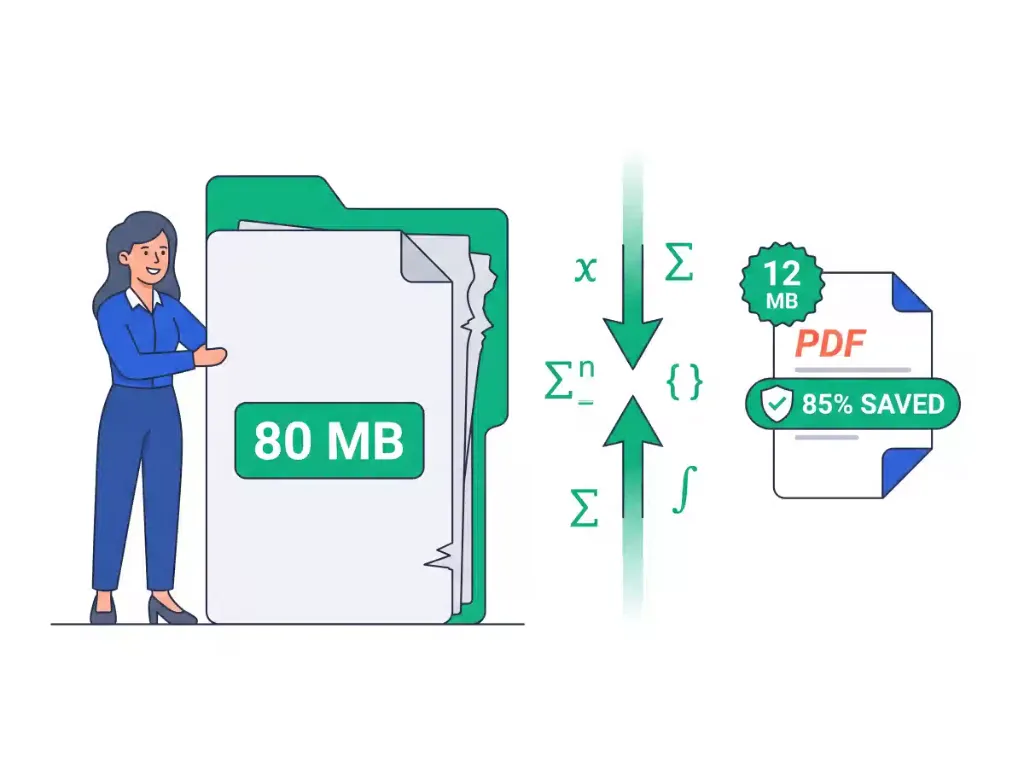
Náš dvoupasový kompresní engine funguje zcela v rámci izolovaného prostředí WebAssembly vašeho prohlížeče. V prvním průchodu engine zkontroluje tabulku křížových odkazů (xref) souboru PDF, odstraní neodkázané mrtvé revize, odstraní nepodstatné tabulky nápovědy TrueType (jako hdmx, VDMX, LTSH a PCLT) a zmenší datové proudy nezpracovaných objektů (/ObjStm), aniž by se dotkl vektorů glyfů textu.
Když je vyžadováno větší zmenšení, druhý průchod vyhodnotí vložené rastrové obrázky. Pomocí kvantizace diskrétní kosinusové transformace (DCT) úrovně MozJPEG jsou vložené fotografie podvzorkovány na kalibrované cíle DPI (96 až 150 DPI) a znovu vloženy do přesných fyzických hranic stránky. Protože všechny výpočty probíhají v paměti RAM vašeho zařízení prostřednictvím Web Workers, vaše dokumenty zůstávají 100% soukromé s rychlostí provádění pod jednu sekundu.