Multinook

Dzielnik i ekstraktor PDF

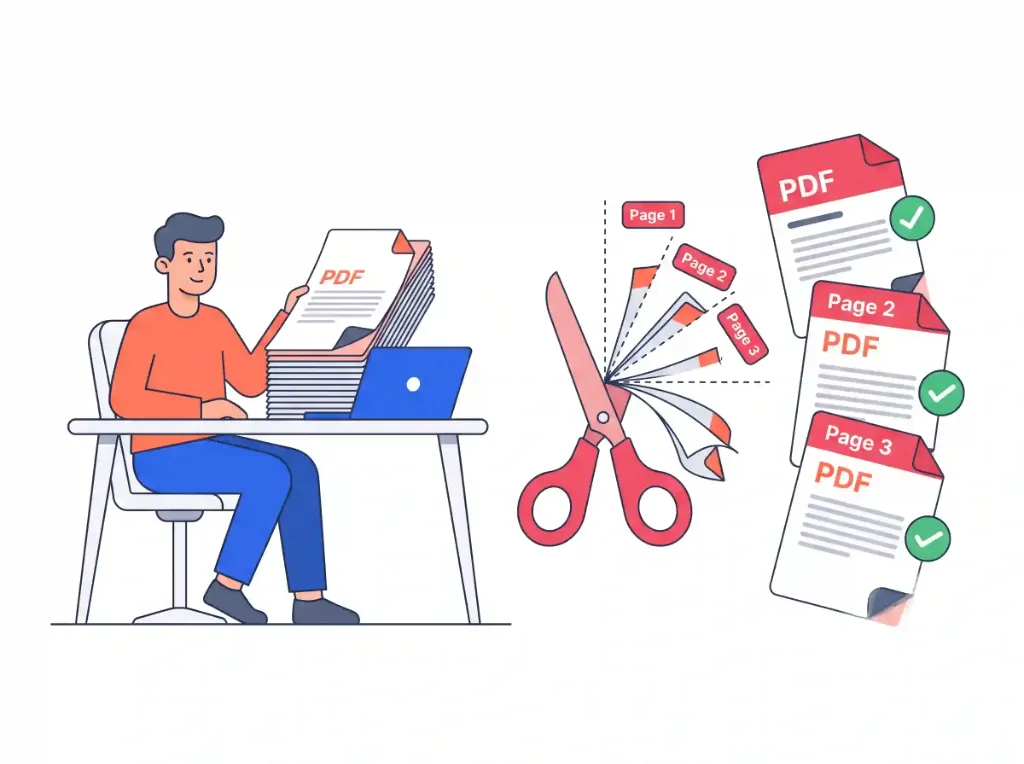
Wyodrębnij określone strony lub podziel plik PDF na niezależne dokumenty

Initializing In-Browser RAM Sandbox...
Dzielnik i ekstraktor PDF — Architektura techniczna i specyfikacja
Wydajny silnik

Dzielnik i ekstraktor PDF

Wybieraj zakresy stron, przeglądaj poszczeg。lne arkusze i natychmiast pobieraj oddzielne pliki PDF bez opóźnień serwera.

Wizualny wybór miniatury strony
Niestandardowa składnia zakresu
Natychmiastowy eksport wielu plików
Zero czekania
Prywatność danych w systemie izolowanym

Absolutna poufność bez przesyłania plików

Twoje pliki są przetwarzane ściśle w pamięci RAM Twojego urządzenia za pomocą WebAssembly. Zero przesyłania do chmury.

Przetwarzanie w 100% w pamięci RAM przeglądarki • Zero przesyłania na serwer
Prywatność danych w systemie izolowanym
Instrukcja krok po kroku

Jak korzystać online: Dzielnik i ekstraktor PDF

Wykonaj te 3 proste kroki, aby przetworzyć dokumenty bezpośrednio w przeglądarce bez żadnych instalacji.

1

Załaduj wielostronicowy PDF

Upuść dokument, aby wizualnie podejrzeć wszystkie miniatury stron z renderowaniem poniżej sekundy.

2

Wybierz strony lub zakresy

Kliknij karty poszczególnych stron lub określ składnię niestandardowego zakresu (np. 1-5, 8, 11-14), aby wyodrębnić docelowe arkusze.

3

Pobierz podzielone pliki

Wyeksportuj wybrane strony jako jeden zunifikowany plik PDF lub jako osobne pliki w skompresowanym archiwum ZIP.

Test porównawczy prywatności i wydajności

Dlaczego Multinook przewyższa tradycyjne konwertery chmurowe

Zobacz, jak architektura WebAssembly po stronie klienta wypada w porównaniu z konwencjonalnymi usługami przesyłania do chmury.

Wyodrębnianie stron

Multinook
Wizualny wycinak zakresu
iLovePDF / Adobe
Limit 2 plików dziennie

Cennik i zapora płatności

Multinook
100% darmowy na zawsze
iLovePDF / Adobe
$19.99/mies. (Adobe)

Wieloplikowość wsadowa

Multinook
Natychmiastowy pakiet ZIP
iLovePDF / Adobe
Wolna kolejka w chmurze

Przesyłanie pliku do chmury

Multinook
0 bajtów (lokalna pamięć RAM)
iLovePDF / Adobe
Przesłane na serwer

Ryzyko prywatności danych

Multinook
0% (izolowane powietrzem)
iLovePDF / Adobe
Przechowywane w chmurze
Architektura techniczna i specyfikacja

Specyfikacja i zgodność formatów

Zaprojektowane ściśle zgodnie ze specyfikacjami W3C WebAssembly i Typed Array.

Technologia cięciaCięcie strumienia niskiego poziomu bajtów (bez ponownej kompresji)
Silnik składni zakresuDynamiczny parser gramatyki czasu rzeczywistego (1-5, 8, 11-14)
Tryby eksportuPojedynczy skonsolidowany PDF lub archiwum ZIP z wieloma plikami PDF
Transmisja danych0 przesłanych bajtów • Izolacja RAM w 100% w przeglądarce
Przycinanie drzewa stronDereferencja izolowanego obiektu /Pages i zbieranie śmieci
Prywatność i zgodnośćPiaskownica bez przechowywania danych zgodna z RODO, HIPAA i CCPA
Najczęstsze zapytania

Często zadawane pytania

Wszystko, co musisz wiedzieć o prywatności, bezpieczeństwie, limitach plików i użytkowaniu.

Masz dwie intuicyjne metody: kliknij bezpośrednio karty miniatur poszczególnych stron, aby przełączyć zaznaczenie, lub wpisz składnię niestandardowego zakresu na pasku wprowadzania (taką jak 1-5, 8, 11-14). Nasz parser natychmiast weryfikuje Twój zakres w czasie rzeczywistym i wyróżnia dokładnie te arkusze, które mają zostać wyodrębnione.
Tak. Wybierz tryb podziału „Oddzielny PDF dla każdej strony”. Silnik dzieli każdą poszczególną stronę na jej własny, samodzielny plik PDF i pakuje je w uporządkowane, skompresowane archiwum ZIP w celu pobrania jednym kliknięciem.
Nie. Nasze narzędzie wykonuje bezpośrednią ekstrakcję strumienia na poziomie bajtów. W przeciwieństwie do narzędzi, które ponownie renderują lub kompresują strony, nasz silnik kopiuje leżące u podstaw strumienie wektorowe, czcionki i obrazy bez ponownego kodowania. Wyodrębniony PDF zachowuje 100% swojej pierwotnej rozdzielczości, metadanych i wierności wizualnej.
Na pasku opcji wybierz „Połącz wybrane w 1 PDF”, jeśli chcesz wyodrębnić strony nieciągłe (np. strony 2, 5 i 9) do jednego spójnego dokumentu. Wybierz „Oddzielny PDF dla każdej strony”, jeśli potrzebujesz każdej wybranej strony zapisanej jako osobny plik.
Tak. Wykorzystując dzielenie ArrayBuffer na fragmenty i zwalniając deskryptory nieoznaczonych stron z lotnej pamięci, nasz silnik WebAssembly działający po stronie klienta może bez wysiłku dzielić dokumenty liczące setki stron na standardowych laptopach i telefonach komórkowych bez zamrażania przeglądarki.

Bezstratne cięcie strumienia na poziomie bajtów a degradacja przy ponownym kodowaniu

Wiele podstawowych programów do dzielenia plików PDF ponownie renderuje strony za pomocą wirtualnego sterownika drukarki lub ponownie kompresuje osadzoną grafikę, co prowadzi do zauważalnych artefaktów kompresji obrazu, błędów podstawiania czcionek i usunięcia adnotacji z hiperłączami.

Nasze narzędzie wykonuje bezpośrednią ekstrakcję strumienia na poziomie bajtów. Nasz silnik WebAssembly analizuje odniesienia do obiektów stron z wybranego zakresu (np. strony 1-5, 8, 11-14) i kopiuje oryginalne strumienie zawartości bit po bicie do świeżo skompilowanego opakowania dokumentu PDF. Osadzone czcionki wektorowe, obrazy o oryginalnym DPI i przestrzenie kolorów pozostają całkowicie nienaruszone.

Skalowalna ekstrakcja dla ciężkich dokumentów skanowanych

Podczas pracy z 500-stronicowymi aktami sądowymi, dossier hipoteki czy zarchiwizowanymi rysunkami architektonicznymi, tradycyjne narzędzia internetowe ulegają awarii lub przekraczają limit czasu ze względu na ograniczenia rozmiaru przesyłania do chmury.

Ponieważ nasze narzędzie przetwarza pliki w pamięci lokalnej przeglądarki przy użyciu mapowania pamięci ArrayBuffer, z łatwością obsługuje gigantyczne pliki liczące wiele setek stron. Możesz odizolować konkretne rozdziały stron w jeden skonsolidowany plik PDF lub rozbić każdą stronę na niezależne pliki PDF spakowane w jedno archiwum ZIP.

Zweryfikowane bezpieczeństwo w 100% w pamięci RAM przeglądarki
Zaktualizowane pod kątem standardów internetowych na rok 2026