Multinook

PDF Splitsen & Extraheren

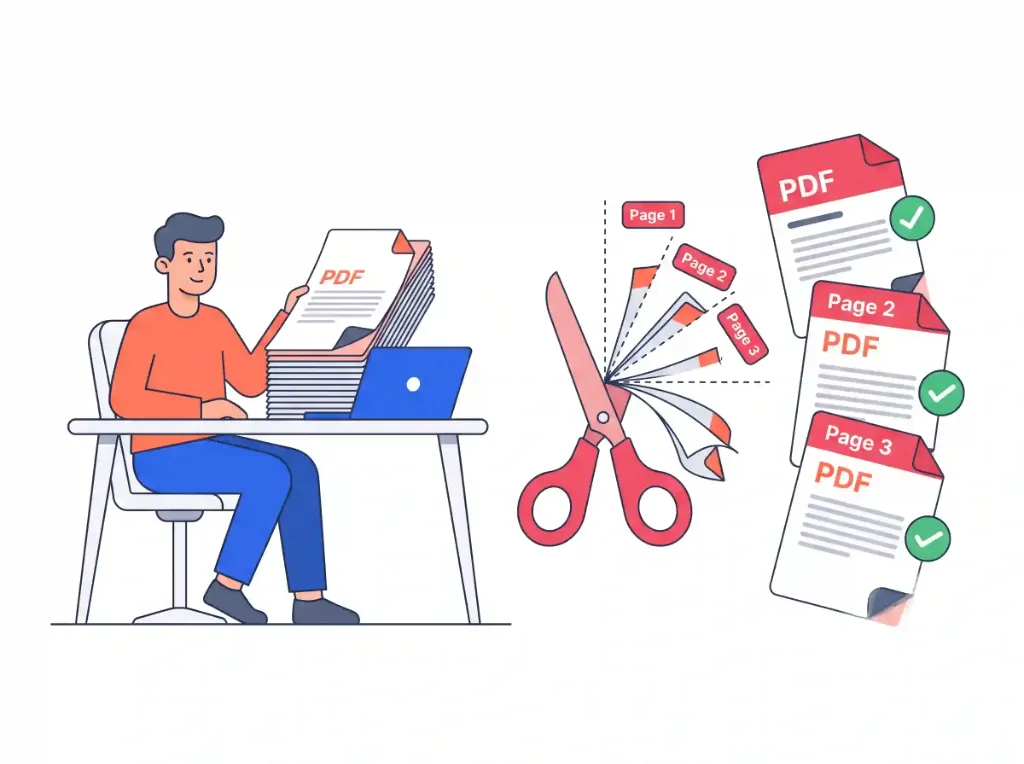
Extraheer specifieke pagina's of splits een PDF in losse documenten

Initializing In-Browser RAM Sandbox...
PDF Splitsen & Extraheren — Technische architectuur & specificaties
Krachtige engine

PDF Splitsen & Extraheren

Selecteer paginabereiken, bekijk losse pagina's en download direct afzonderlijke PDF-bestanden zonder vertraging.

Visuele paginaminiaturenkiezer
Aangepaste bereiksyntax
Directe export van meerdere bestanden
Geen wachttijd
Air-gapped dataprivacy

Absolute vertrouwelijkheid met nul uploads

Uw bestanden worden strikt binnen het RAM van uw apparaat verwerkt met behulp van WebAssembly. Nul cloud-uploads.

100% in-browser RAM-verwerking • Nul server-uploads
Air-gapped dataprivacy
Stapsgewijze instructies

Hoe online te gebruiken: PDF Splitsen & Extraheren

Volg deze 3 eenvoudige stappen om uw documenten rechtstreeks in uw browser te verwerken zonder installaties.

1

Laad PDF met meerdere pagina's

Sleep uw document om alle paginaminiaturen visueel te bekijken met sub-seconde rendering.

2

Selecteer pagina's of bereiken

Klik op individuele paginakaarten of geef aangepaste bereiksyntaxis op (bijv. 1-5, 8, 11-14) om de doelvellen te extraheren.

3

Download gesplitste bestanden

Exporteer geselecteerde pagina's als een enkele uniforme PDF of als afzonderlijke individuele bestanden in een gecomprimeerd ZIP-archief.

Privacy- & prestatiebenchmark

Waarom Multinook beter presteert dan traditionele cloud-converters

Bekijk hoe de client-side WebAssembly-architectuur presteert in vergelijking met conventionele cloud-uploadservices.

Pagina-extractie

Multinook
Visuele Bereiksnijder
iLovePDF / Adobe
Limiet van 2 bestanden/dag

Prijzen & Betaalmuur

Multinook
100% Altijd Gratis
iLovePDF / Adobe
$19,99/mnd (Adobe)

Batch meerdere bestanden

Multinook
Directe ZIP-bundel
iLovePDF / Adobe
Trage Cloud-wachtrij

Cloud-bestandsupload

Multinook
0 bytes (Lokaal RAM)
iLovePDF / Adobe
Geüpload naar server

Gegevensprivacyrisico

Multinook
0% (Air-Gapped)
iLovePDF / Adobe
Opgeslagen in cloud
Technische architectuur & specificaties

Specificaties & formaatcompatibiliteit

Strikt ontworpen volgens de W3C WebAssembly- en Typed Array-specificaties.

SnijtechnologieLow-Level Byte Stream Slicing (Geen hercompressie)
Bereik Syntaxis EngineReal-Time Dynamic Grammar Parser (1-5, 8, 11-14)
ExportmodiEnkele geconsolideerde PDF of Multi-PDF ZIP-archief
Gegevensoverdracht0 bytes geüpload • 100% In-Browser RAM-isolatie
Paginaboom SnoeienGeïsoleerde /Pages Object Dereferencing & Garbage Collection
Privacy & NalevingGDPR-, HIPAA- en CCPA-compatibele Sandbox zonder opslag
Veelgestelde vragen

Veelgestelde vragen

Alles wat u moet weten over privacy, beveiliging, bestandslimieten en gebruik.

U heeft twee intuïtieve methoden: klik rechtstreeks op individuele paginaminiatuurkaarten om de selectie in of uit te schakelen, of typ de aangepaste bereiksyntaxis in de invoerbalk (zoals 1-5, 8, 11-14). Onze parser valideert uw bereik direct in realtime en markeert de exacte vellen die gepland staan voor extractie.
Ja. Kies de splitsmodus "Afzonderlijke PDF voor elke pagina". De engine snijdt elke afzonderlijke pagina in een eigen stand-alone PDF-bestand en bundelt ze in een georganiseerd, gecomprimeerd ZIP-archief om met 1 klik te downloaden.
Nee. Onze tool voert directe byte-level stream-extractie uit. In tegenstelling tot tools die pagina's opnieuw renderen of comprimeren, kopieert onze engine de onderliggende vectorstreams, lettertypen en afbeeldingen zonder opnieuw te coderen. De geëxtraheerde PDF behoudt 100% van zijn oorspronkelijke resolutie, metagegevens en visuele getrouwheid.
Selecteer in de optiebalk "Geselecteerde samenvoegen tot 1 PDF" als u niet-opeenvolgende pagina's (bijv. pagina 2, 5 en 9) wilt extraheren naar één samenhangend document. Selecteer "Afzonderlijke PDF voor elke pagina" als u wilt dat elke geselecteerde pagina als afzonderlijk bestand wordt opgeslagen.
Ja. Door gebruik te maken van gechunkeerde ArrayBuffer-snijding en niet-geselecteerde paginadescriptoren vrij te geven uit het vluchtige geheugen, kan onze client-side WebAssembly-engine moeiteloos documenten met honderden pagina's splitsen op standaard laptops en mobiele telefoons zonder dat de browser vastloopt.

Lossless Byte-Level Stream Slicing vs Re-Encoding Degradation

Veel basis hulpprogramma's voor het splitsen van PDF's renderen pagina's opnieuw via een virtueel printstuurprogramma of comprimeren ingesloten afbeeldingen opnieuw, wat leidt tot merkbare afbeeldingscompressie-artefacten, lettertypevervangingsfouten en verwijderde gehyperlinkte annotaties.

Onze tool voert directe byte-level stream-extractie uit. Onze WebAssembly-engine parseert de pagina-objectreferenties van uw doelbereik (bijv. pagina's 1-5, 8, 11-14) en kopieert de originele inhoudsstreams bit voor bit naar een vers gecompileerde PDF-documentwrapper. Ingesloten vectorlettertypen, originele DPI-afbeeldingen en kleurruimten blijven volledig ongewijzigd.

Schaalbare extractie voor zware gescande documenten

Bij het werken met rechtbankdossiers van 500 pagina's, hypotheekdossiers of gearchiveerde bouwtekeningen, crashen traditionele webtools of verlopen ze vanwege beperkingen in de grootte van cloud-uploads.

Omdat onze tool bestanden verwerkt in het geheugen van uw lokale browser met behulp van ArrayBuffer-geheugentoewijzing, kan deze gemakkelijk enorme bestanden met honderden pagina's aan. U kunt specifieke paginahoofdstukken isoleren in één geconsolideerde PDF of elke pagina loskoppelen in onafhankelijke PDF's gebundeld in één ZIP-archief.

Geverifieerde 100% in-browser RAM-beveiliging
Bijgewerkt voor de webstandaarden van 2026