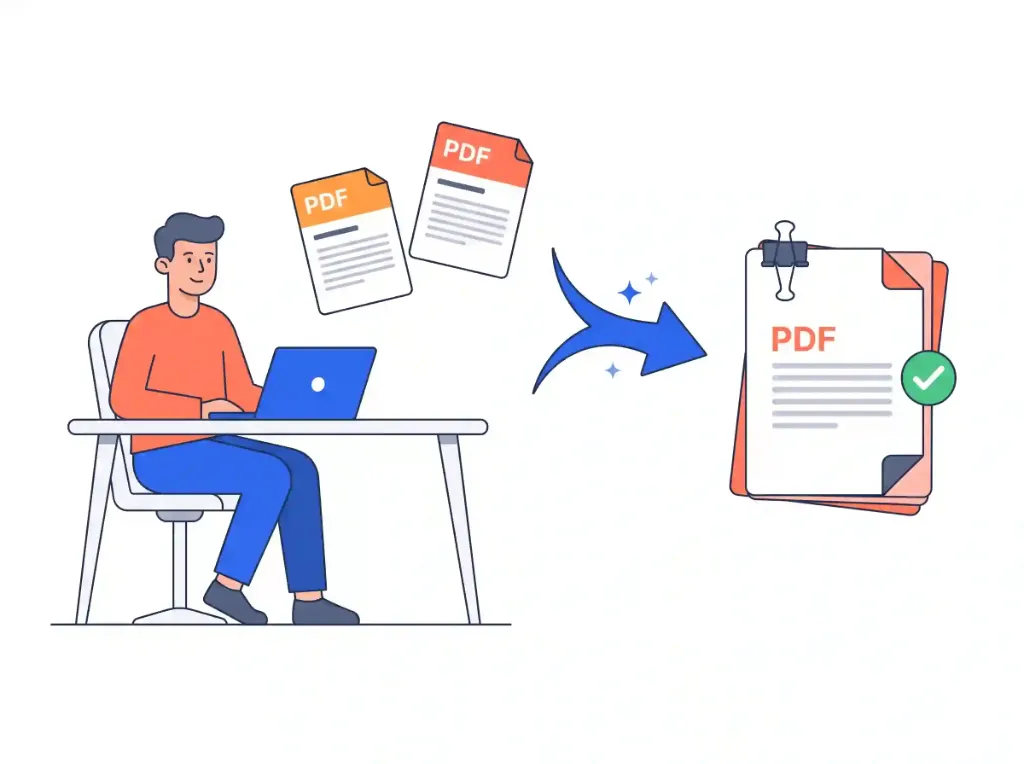
Բարձր արդյունավետությամբ հիշողության մեջ PDF հոսքերի միավորում
Մի քանի PDF փաստաթղթերի միավորումը պահանջում է շատ ավելին, քան պարզապես երկու երկուական ֆայլերի իրար մ��ացումը: Յուրաքանչյուր անկախ PDF ունի իր սեփական փաստաթղթային կատալոգը, էջերի ծառի հիերարխիան, անուղղակի օբյեկտների բառարանը (/ObjStm), ներդրված տառատեսակների նկարագրիչները և խաչաձև հղման աղյուսակը:
Մեր գործիքն օգտագործում է ցածր մակարդակի WebAssembly հիշողության քարտեզագրում՝ յուրաքանչյուր մուտքագրվող փաստաթղթի կառուցվածքային բառարանները ուղղակիորեն բրաուզերի RAM-ում վերլուծելու համար: Մեր շարժիչը հաջորդականորեն վերաինդեքսավորում է բոլոր անուղղակի օբյեկտների հղման ID-ները, միավորում /Pages հանգույցների ծառերը միասնական գծային հիերարխիայի մեջ և հեռացնում կրկնօրինակները տառատեսակների աղյուսակներից՝ ֆայլի անհարկի ուռճացումը կանխելու համար:
Քանի որ էջերի ամբողջ մշակումը հաշվարկվում է տեղում՝ ձեր CPU հոսքերի վրա, է��երի վերադասավորումը, 90 աստիճանով մեկ թերթիկի պտույտը և փաստաթղթերի միավորումն իրականացվում են միլիվայրկյանների ընթացքում՝ զրոյական ցանցային վերբեռնման ուշացումով: