

Multinook

PDF-Splitter & -Extraktor

Bestimmte Seiten extrahieren oder PDF in unabhängige Dokumente aufteilen

Initializing In-Browser RAM Sandbox...
PDF-Splitter & -Extraktor — Technische Architektur & Spezifikationen
Hochleistungs-Engine

PDF-Splitter & -Extraktor

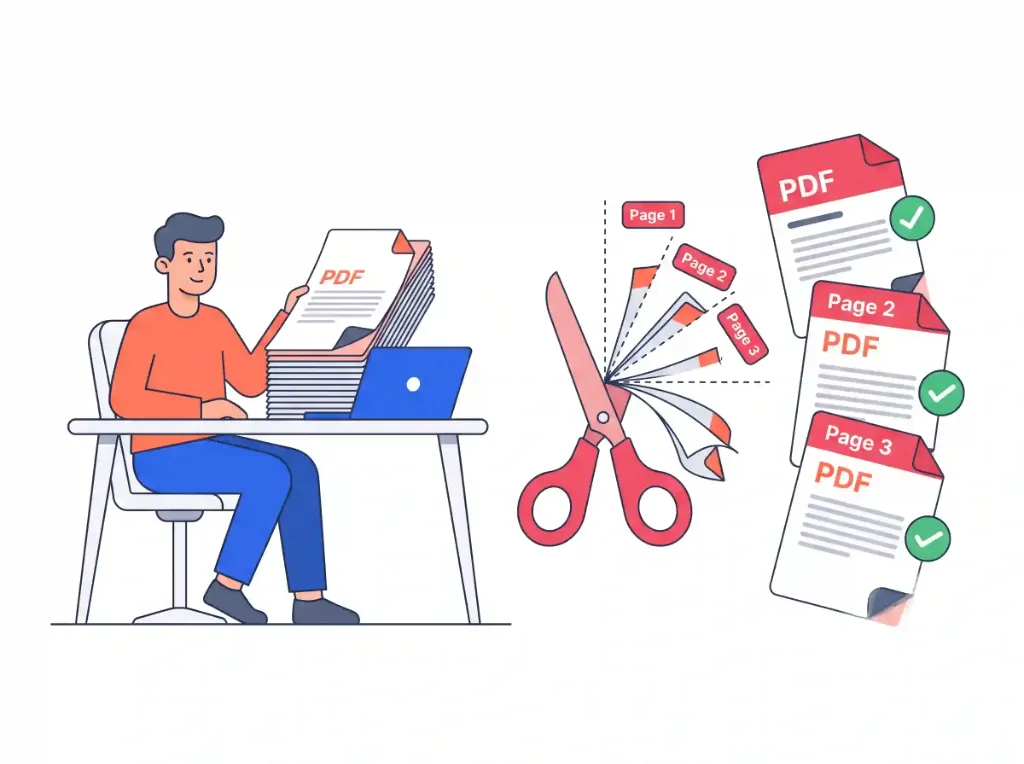
Seitenbereiche auswählen, einzelne Blätter in der Vorschau anzeigen und separate PDF-Dateien ohne Serververzögerung sofort herunterladen.

Visuelle Seitenvorschaubild-Auswahl
Benutzerdefinierte Bereichssyntax
Sofortiger Multi-Dateien-Export
Keine Wartezeit
Isolierte Daten-Privatsphäre

Absolute Vertraulichkeit ohne Uploads

Ihre Dateien werden streng im Arbeitsspeicher Ihres Geräts über WebAssembly verarbeitet. Null Uploads.

100% In-Browser RAM • Null Server-Uploads
Isolierte Daten-Privatsphäre
Schritt-für-Schritt-Anleitung

Online verwenden: PDF-Splitter & -Extraktor

Folgen Sie diesen 3 einfachen Schritten, um Ihre Dokumente direkt im Browser ohne Installation zu verarbeiten.

1

Mehrseitige PDF laden

Ziehen Sie Ihr Dokument in den Bereich, um alle Seitenvorschaubilder mit ultraschnellem Rendering direkt anzuzeigen.

2

Seiten oder Bereiche auswählen

Klicken Sie auf einzelne Seitenkarten oder geben Sie eine benutzerdefinierte Syntax ein (z. B. 1-5, 8, 11-14), um Zielseiten zu extrahieren.

3

Geteilte Dateien herunterladen

Exportieren Sie ausgewählte Seiten als ein einziges kombiniertes PDF oder als separate Einzeldateien in einem komprimierten ZIP-Archiv.

Datenschutz- & Performance-Benchmark

Warum Multinook herkömmliche Cloud-Konverter übertrifft

Erfahren Sie, wie clientseitige WebAssembly herkömmliche Cloud-Uploads übertrifft.

Seitenextraktion

Multinook
Visueller Bereichs-Slicer
iLovePDF / Adobe
Limit von 2 Dateien/Tag

Preise & Paywall

Multinook
100% dauerhaft kostenlos
iLovePDF / Adobe
19,99 $/Monat (Adobe)

Stapelverarbeitung (Multi-File)

Multinook
Sofortiges ZIP-Paket
iLovePDF / Adobe
Langsame Cloud-Warteschlange

Cloud-Dateiupload

Multinook
0 Byte (lokaler RAM)
iLovePDF / Adobe
Auf Server hochgeladen

Datenschutzrisiko

Multinook
0 % (isoliert / Air-Gapped)
iLovePDF / Adobe
In der Cloud gespeichert
Technische Architektur & Spezifikationen

Spezifikationen & Formatkompatibilität

Exakt nach W3C WebAssembly- und Typed-Array-Standards entwickelt.

Slicing-TechnologieLow-Level Byte-Stream-Slicing (keine Neukomprimierung)
Bereichssyntax-EngineDynamischer Echtzeit-Grammatik-Parser (1-5, 8, 11-14)
ExportmodiEinzelnes konsolidiertes PDF oder Multi-PDF-ZIP-Archiv
Datenübertragung0 Byte hochgeladen • 100 % In-Browser-RAM-Isolierung
Seitenbaum-BereinigungIsolierte /Pages-Objekt-Dereferenzierung & Garbage Collection
Datenschutz & ComplianceDSGVO-, HIPAA- und CCPA-konforme Sandbox ohne Speicher
Häufige Anfragen

Häufig gestellte Fragen

Alles über Datenschutz, Sicherheit, Dateilimits und Nutzung.

Sie haben zwei intuitive Methoden: Klicken Sie direkt auf die Miniaturansichten der einzelnen Seiten, um die Auswahl umzuschalten, oder geben Sie die Syntax für benutzerdefinierte Bereiche in die Eingabeleiste ein (wie 1-5, 8, 11-14). Unser Parser validiert Ihren Bereich sofort in Echtzeit und hebt die exakten Seiten hervor, die für die Extraktion vorgesehen sind.
Ja. Wählen Sie den Aufteilungsmodus „Für jede Seite ein separates PDF“. Die Engine teilt jede einzelne Seite in eine eigene eigenständige PDF-Datei auf und fasst sie für den 1-Klick-Download in einem organisierten, komprimierten ZIP-Archiv zusammen.
Nein. Unser Tool führt eine direkte Byte-Level-Stream-Extraktion durch. Im Gegensatz zu Tools, die Seiten neu rendern oder komprimieren, kopiert unsere Engine die zugrundeliegenden Vektostreams, Schriftarten und Bilder ohne Neuankodierung. Die extrahierte PDF behält 100 % ihrer ursprünglichen Auflösung, Metadaten und visuellen Wiedergabetreue bei.
Wählen Sie in der Optionsleiste „Ausgewählte in 1 PDF zusammenführen“, wenn Sie nicht aufeinanderfolgende Seiten (z. B. Seite 2, 5 und 9) in ein einziges zusammenhängendes Dokument extrahieren möchten. Wählen Sie „Für jede Seite ein separates PDF“, wenn jede ausgewählte Seite als einzelne Datei gespeichert werden soll.
Ja. Durch die Nutzung von in Chunks aufgeteiltem ArrayBuffer-Slicing und die Freigabe nicht ausgewählter Seitendeskriptoren aus dem flüchtigen Speicher kann unsere clientseitige WebAssembly-Engine Dokumente mit Hunderten von Seiten auf Standard-Laptops und Mobiltelefonen mühelos aufteilen, ohne den Browser einzufrieren.

Verlustfreies Byte-Level-Stream-Slicing vs. Neukodierungs-Qualitätsverlust

Viele einfache PDF-Splitting-Dienstprogramme rendern Seiten über einen virtuellen Druckertreiber neu oder komprimieren eingebettete Grafiken, was zu spürbaren Bildkomprimierungsartefakten, Fehlern bei der Schriftartenersetzung und entfernten Hyperlink-Anmerkungen führt.

Unser Tool führt eine direkte Byte-Level-Stream-Extraktion durch. Unsere WebAssembly-Engine analysiert die Seitenobjektverweise Ihres Zielbereichs (z. B. Seiten 1-5, 8, 11-14) und kopiert die ursprünglichen Inhalts-Streams Bit für Bit in einen frisch kompilierten PDF-Dokument-Wrapper. Eingebettete Vektorschriftarten, Original-DPI-Bilder und Farbräume bleiben völlig unberührt.

Skalierbare Extraktion für schwere gescannte Dokumente

Bei der Arbeit mit 500-seitigen Gerichtsakten, Hypothekendossiers oder archivierten Architekturzeichnungen stürzen herkömmliche Webtools aufgrund von Beschränkungen der Cloud-Upload-Größe ab oder laufen in ein Zeitlimit.

Da unser Tool Dateien im Arbeitsspeicher Ihres lokalen Browsers mithilfe von ArrayBuffer-Speicherzuordnung verarbeitet, verarbeitet es mühelos massenhafte Dokumente mit vielen hundert Seiten. Sie können bestimmte Seitenkapitel in ein einziges konsolidiertes PDF isolieren oder jede Seite in unabhängige PDFs aufteilen, die in einem einzigen ZIP-Archiv gebündelt sind.

Geprüfte 100% In-Browser-RAM-Sicherheit
Aktualisiert für 2026 Webstandards